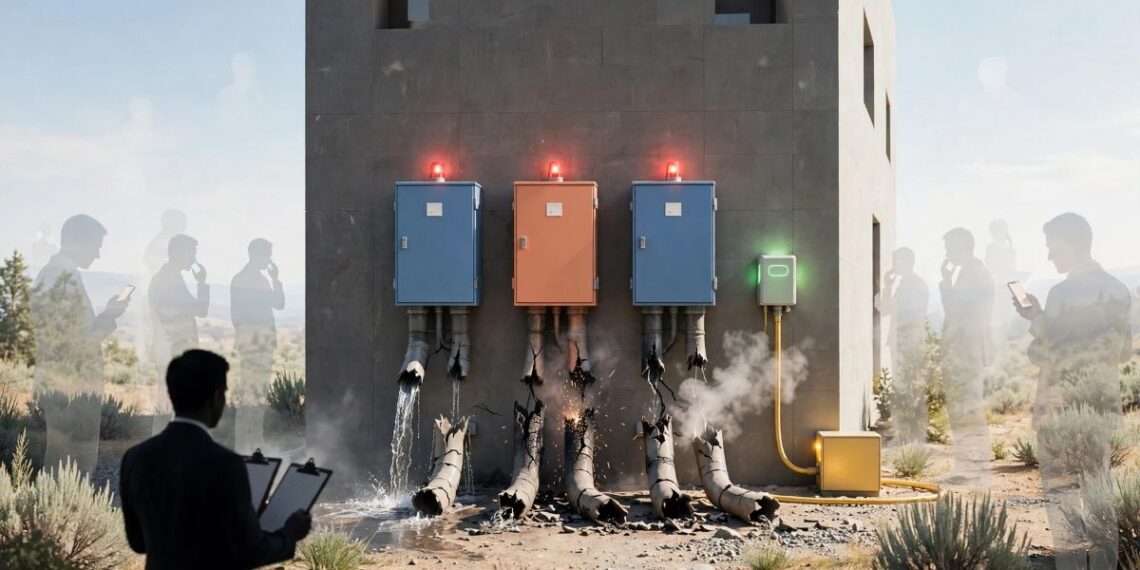
誰能想到,那些由 AI 產出的華麗情報,竟然可能是一場摧毀企業的決策災難?
那麼,企業最稀缺的資產究竟是什麼?答案不是未經證實的生成內容,而是高度沉澱、能承擔決策責任的真人智慧。
目前產業充斥著雙重焦慮:一是害怕落後的「追逐焦慮」,導致盲目導入工具;二是資訊通膨引發的「數據垃圾與幻覺焦慮」。這裡指的數據垃圾,是 AI 互相洗稿、隨機生成且缺乏實質根基的垃圾資訊。
迷信 AI 會付出慘痛代價。像二零二五年第三季,全球算力競賽讓亞洲晶圓代工產能移向資料中心,車用晶片因而斷貨。依賴演算法管理庫存的大廠未察覺第一線產能排擠,被迫以數倍天價搶購,導致利潤腰斬。
根據 台灣 CIO 雜誌 報導,產業情報就像巨大冰山,AI 只能觸及水面的數位表層,例如公開新聞與財報。這些資訊通常時間落後且充斥粉飾性數據,毫無戰略價值。
而決定勝負的「隱形產業知識」則深埋在冰山之下。這是指未被數位化、無法搜尋,必須深耕現場才能取得的真實情報。
看看四個真實產業現場:
第一,虛幻供應鏈門檻:某廠宣稱打入國際雲端大廠供應鏈,但實地走訪發現,僅一套樣品通過測試,距離量產還很遙遠。
第二,概念產能落差:某金屬廠宣稱打入低軌衛星供應鏈,但實地考察發現,百分之九十五的機台仍在生產傳統鐵捲門零件,低軌衛星產線僅佔角落一台機台,年營收貢獻不到百分之二。
第三,交易繁榮的物流黑洞:某電商宣稱海外交易額年增百分之三百,但實際退貨率高達百分之五十,由於跨境逆向物流成本極高,半數退貨只能就地報廢,淨利直接減半。
第四,標案光環的低毛利真相:某公司拿下政府十億元標案,但其中六億元都是過水代購硬體,該公司僅能賺取微薄的轉手毛利。
為什麼大語言模型學不會這些?因為沒有被數位化,AI 知識庫只能是二手、落後且公開的資訊。要汲取隱形知識,必須仰賴分析師實地踏查與高層訪談。
這不代表要排斥 AI 工具。我們應重新設計情報架構:讓 AI 負責廣度與速度,處理基礎資料檢索;而人類智慧專注於深度與真實,進行最終的脈絡詮釋與決策。