
當企業內部的 AI 助理普及到十萬名員工,每天處理的運算量衝上四百五十億個詞元時,爆表的神仙帳單該怎麼救?
先來解釋什麼是詞元。詞元是人工智慧處理語言的基本單位,就像把一段話拆解成一個個字詞或文字碎片。AI 處理的詞元數量越多,企業付給模型供應商的費用就越驚人。
根據 台灣 CIO 雜誌 報導,美國一家大型電信業者在短短幾個月內,每日詞元用量從八十億一路暴增到四百五十億,每月消耗超過一兆個詞元。
許多人以為,現在模型算力單價正在快速下跌,三個月內跌了近一半,AI 帳單應該越來越便宜才對?答案恐怕正相反。隨著企業全面改用能自動規劃流程的 AI 代理,也就是能幫人類完成複雜多步驟任務的智慧助理,處理單一任務所需的詞元量直接飆升五到三十倍。預計幾年內,企業的 AI 推論成本將會暴漲五倍以上。
面對這場詞元風暴,這家電信巨頭選擇自救。他們發現一個關鍵痛點:同仁們習慣預設使用最新、最強的前沿封閉模型,但實際上只有極少數複雜工作需要頂級能力,大多數例行任務用低成本模型處理,效果完全不會打折扣。
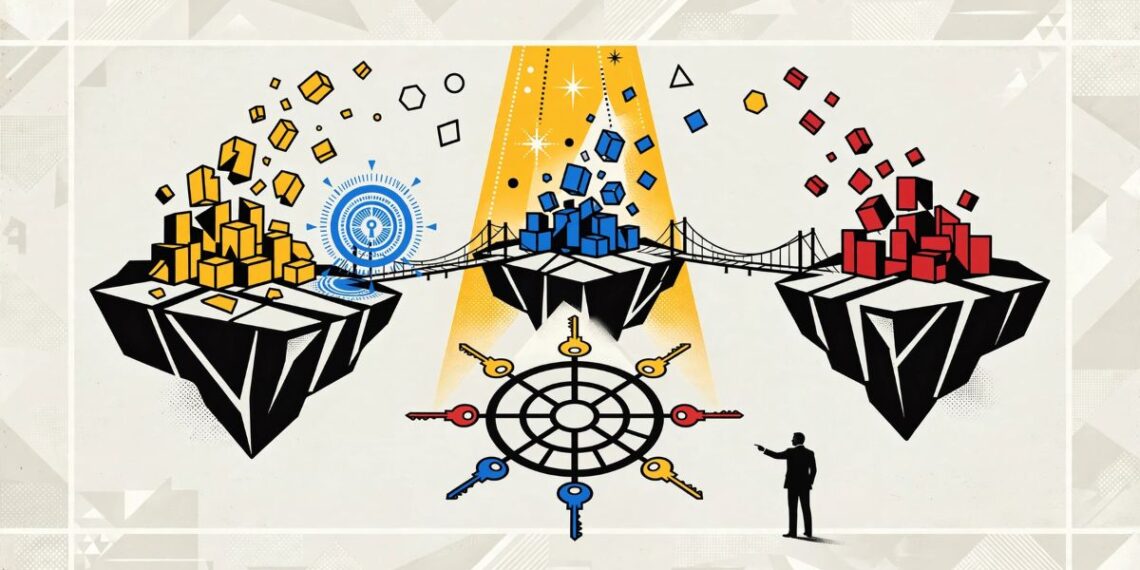
他們該怎麼做呢?答案是自建 AI 閘道器。所謂 AI 閘道器,就像是一位智慧交通警察,每當同仁發出提問,系統就會即時計算回應速度、花費成本與品質要求,自動把任務分發給最划算的模型。
例如,閱讀既有程式碼並做出說明這類運算量較低的工作,就交給開源模型處理。開源模型是指公開技術與架構的模型,企業可以免費下載並自行調整。至於需要從頭撰寫全新程式碼的複雜工作,才調用頂級的封閉模型。光是這樣的分流機制,就讓程式碼相關工作的成本大幅降低百分之五十六,而輸出品質僅僅微幅下降百分之二。
除了聰明分流,他們更進一步訓練專屬的電信開放模型。他們以開放模型 Gemma 為基底,處理超過一兆個詞元的電信專業文件與數據,打造出參數量三百一十億的專用模型。這個模型可以在企業地端伺服器順利執行,資料完全不必外流。
結果如何?部分應用在從封閉模型切換到自研開放模型後,成本直接暴跌百分之八十至百分之九十!整體 AI 專案更是創造出五倍的投資報酬率。
這套結合智慧閘道器、專屬模型、治理與安全的做法,讓企業成功實現了資料主權,不再被特定晶片或軟體廠商硬性綁架。