每一次的企業轉型都是一場蛻變
企業轉型之路無盡頭,每一次轉型涵蓋躍進機會以外的意義,屬於為下一次轉型打下根基的準備。
編撰/何信達‧校訂╱CIO 編輯室
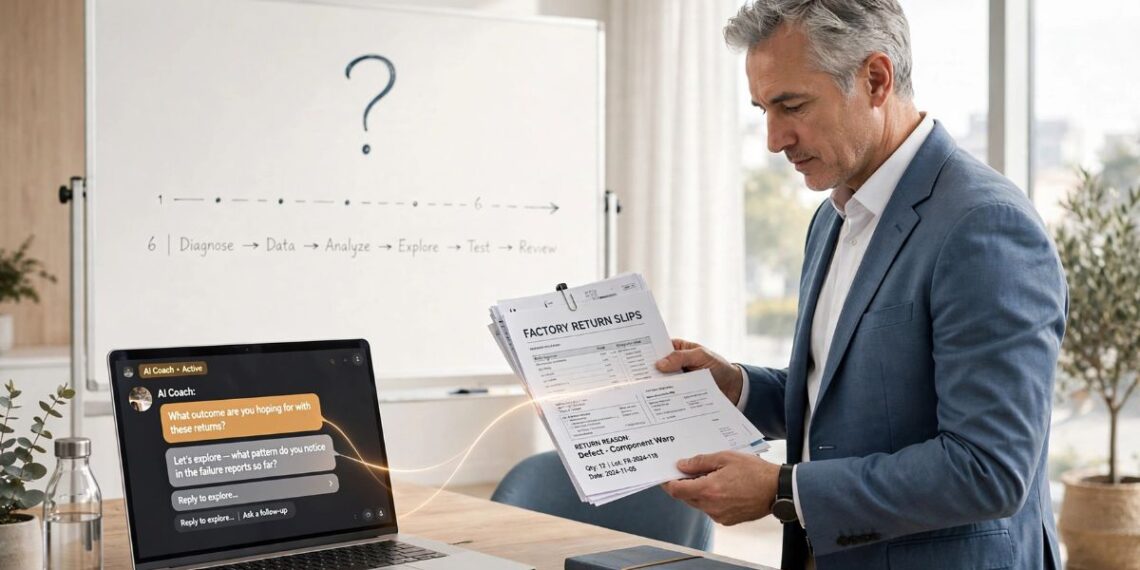
企業投入 AI 轉型的資源逐年攀升,但多數專案卡在試點階段,遲遲無法規模化。多個案例研究顯示,決定 AI 轉型成敗的環節,發生在 AI 模型本身之外——像是資料是否先被整理乾淨、員工是否願意使用、基礎架構撐不撐得住規模化部署,以及責任分工是否在出事之前就已經釐清等項目。
生技製藥公司 Moderna 技術長 Brad Miller 曾在 2023 年 11 月該公司數位投資人活動上公布:儘管高達九成的科技主管相信 AI 是下一場科技革命的核心,但到最後只有 10% 的 AI 專案進入量產。同樣投入資源、同樣相信 AI 的潛力,最終卻只有 10% 走到量產階段——歸咎其中的差異,發生在企業投入 AI「之前」先做了哪些準備。Brad Miller 說明:「我們除了改變這個現象,還要以身作則」,並提出具體數字佐證——公司自有的生成式 AI 工具 mChat,在具備使用裝置的員工當中,活躍使用率超過一半。
六項前置工程決定 AI 能否從試點走向規模化
同樣是投入資源做 AI 轉型,最後能走到量產階段的關鍵在哪裡?決定的環節也許發生在 AI 模型之外。以下項目可以逐一檢視:
- 投入的時間有多長
- 員工願不願意用
- 資料本身的結構化程度
- 基礎架構是否撐得住規模化
- 供應商佈局的決定方式
- 責任分工是否明確
這六個項目我們都找到一些案例做輔證。
1. 投入的時間有多長
在特化化學業,印度企業 Jubilant Ingrevia 在導入 AI 之前,先讓 McKinsey 旗下 QuantumBlack 的數據科學家跟廠區操作員並肩工作四個月,重建對製程與各分廠作業成熟度的理解,這個案例被 McKinsey 發表在 2025 年 11 月;在金融業,DBS Bank 於 2024 年受訪時,向 ComputerWeekly 說明,DBS 過去七年持續投入資料基礎建設,早在「Big Data」成為流行詞彙之前就已經開始。這段前置投入不會出現在 AI 專案的成果報告裡,卻決定了後面的模型有沒有東西可學,能否發揮最大成效。
2. 員工願不願意用
這個環節容易被基礎架構跟資料治理的討論蓋過去,但 Moderna 2023 年 11 月的投資人活動逐字稿提供了目前查證到最具體的做法。當時 Moderna 負責生成式 AI 產品策略的副總裁 Brice Challamel 在會中提出一個內部原則:30% 的心力花在確保技術本身跑得動,70% 則要花在讓使用者理解技術、跟上技術的演進速度。具體執行上,公司設立了 AI Academy,讓從基層到高階主管都有機會學習 AI 的基本原理;另外針對約 170 位資深主管開了為期七週、每週兩次的訓練課程,內容包括如何寫提示詞、如何把 AI 用進日常決策;同時舉辦全公司性質的提示詞競賽,收到超過 180 件跨部門提交的具體用例,範圍從研究人員用 AI 寫程式,到用 AI 生成教育訓練用的故事內容都有。這些做法要花費的包含技術預算,還有管理層願意投入的時間,而且見效期通常比建置一套新系統慢,容易在專案排期時被往後排。
3. 資料本身的結構化程度
當時 Moderna 資料暨分析長 Dave Johnson(CDAO,Chief Data and Analytics Officer)在逐字稿中說明,機器學習演算法不處理隨機文字與試算表,需要乾淨、結構化、機器可讀的資料,這代表企業必須先投入資源把資料整合進資料湖,演算法開發與資料科學家才有東西可用。企業選用的模型再先進,能推論的範圍仍受限於餵給它的資料品質,這項工程通常比選模型花更久時間。
4. 基礎架構是否撐得住規模化
JPMorgan Chase 官方技術部落格說,JPMorgan Chase 技術長辦公室開發的 OmniAI 平台是一套內部 AI 模型維運系統,處理現代 AI/ML 模型套用在複雜傳統系統之上的標準化問題。依照 Walmart 官方技術部落格在 2024 年 3 月的說法,Element 機器學習平台是一套讓公司內部團隊自建、自管 AI 模型的共用工具,要解決的是供應商鎖定、授權費用過高、可用性與可靠性受限這幾項具體障礙。這一項通常是試點與量產之間的分界——用例在小規模測試中成功,不代表底層架構撐得住全公司規模的部署。
5. 供應商佈局的決定方式
這個環節目前查證到的做法各異,沒有單一標準答案,但值得列出幾種實際做法互相對照:JPMorgan 官方技術部落格說明,該銀行透過 LLM Suite 這套統一的員工 AI 使用入口,同時管理 OpenAI 與 Anthropic 兩家供應商,依成本與能力需求自動進行路由請求;Walmart 的 Element 平台設計目標是讓團隊能在多雲環境間切換而不必花時間重新設定;當時 Brad Miller 在 2023 年 11 月的投資人活動逐字稿中說,公司從一開始就與 OpenAI、Microsoft、Amazon、Google 等多家供應商合作,並具備快速在不同大型語言模型間切換的能力。這項決定一旦定案,後續要更換供應商牽動既有系統整合與資料遷移,重新選擇的成本將會遠高於當初決定的成本。
6. 責任分工是否明確
AI 從單一系統走向規模化部署時,會出現一種傳統 IT 治理不常處理的角色——AI 代理人本身變成一個能自行存取資料、呼叫其他系統的行動者,這代表原本只需要管「系統誰在用」的責任範圍,擴大到「這個系統自己在替誰做決定」。JPMorgan 官方技術部落格與 CIO Dive 的報導都提到 JPMorgan CIO Lori Beer 與 JPMorgan CISO Patrick Opet 的分工——Lori Beer 負責定義 AI 代理人的身分分級與規模化基礎,決定什麼層級的工作可以交給代理人自主處理;Patrick Opet 負責處理服務帳號、API 金鑰等非人類身分帶來的風險,因為這些代理人本身持有的存取權限,如果沒人專責監控,會變成新的攻擊面。這項分工在系統正常運作時不太會被注意到,一旦出現模型誤判或資安事件,權責是否清楚會直接反映在企業能多快、多完整地應對——換句話說,責任分工的意義發生在 AI 上線之前,決定了 AI 能不能從單一用例安全地擴大到全公司規模。
Zillow、JPMorgan、DBS 在同一關鍵呈現不同結果
以下為三個歷經沉潛的 AI 轉型案例。
同樣的房價預測能力,AI 化帶來了不同成果
美國房地產平台 Zillow 的 iBuying 演算法,是一個完全不同的例子,哈佛商學院工作論文、GeekWire、SiliconANGLE 等多個獨立來源在 2021 年 11 月當時都進行了報導。因為 Zillow 在 2021 年 11 月宣布關閉其自動購房業務 Zillow Offers,導致 2,000 名員工失業、並在當年第三季認列高達 3.04 億美元減損。Zillow 執行長 Rich Barton 在同月的法說會上向 GeekWire 說明,問題出在演算法本身:公司缺乏信心讓模型準確預測快速變動市場中的房價波動,該季公司仍用這套演算法買下 9,680 戶房屋,預測信心仍顯不足。
Rich Barton 向 GeekWire 說明這個案例的關鍵細節,公司「可以」用黑天鵝事件——疫情、勞動力短缺——當藉口去微調模型、繼續推進,但他判斷這個風險太高。Zillow 投入了資源、具備具體用例、也找到了落地場景——這些 AI 轉型常被強調的要素,Zillow 全部具備。問題出在演算法對市場複雜度的判斷能力,這項判斷能力沒有辦法單靠追加投資解決。
[ 加入 CIO Taiwan 官方 LINE 、 Facebook 與 LinkedIn,與全球CIO同步獲取精華見解 ]
不過該公司的案例值得補上後續發展的說明,因為 Zillow 並沒有因此退出 AI,反而在五年後交出了另一種成果。GeekWire 在 2026 年 2 月的報導提到,Zillow 技術長 David Beitel 說明,工程團隊在人力沒有增加的情況下,靠 AI 輔助開發讓程式碼產出提升最多 15%,公司同時也把 AI 導入 CRM 工具,協助房仲整理通話紀錄、草擬跟進訊息。2026 年 3 月,Zillow 正式發布官方新聞稿推出「Zillow AI Mode」,這是一套用自家資料訓練、非套用第三方通用模型的對話式搜尋助手,買方可以直接用自然語言描述需求,取代過去逐項設定篩選條件的做法。這套系統內建「公平住宅分類器」(Fair Housing Classifier),即時檢查使用者提問與 AI 回覆內容,官方新聞稿明確定調這套工具定位為輔助持牌房仲的專業判斷。GeekWire 在 2026 年 5 月的報導指出,這一連串 AI 布局推出後,Zillow 首季營收年增 18% 達 7.08 億美元,Zillow 執行長 Jeremy Wacksman 在給股東的信中,將 AI 稱為讓公司「愈來愈不可或缺」的關鍵。
同一家公司、同一套核心資產——房價預測能力,五年前用來自主決策買房,換來的是關店與資產減損;五年後用來輔助人類決策並搭配即時的偏誤檢查機制,換來的是營收成長與工程效率提升。這個對照比單一年份的失敗更能說明落差所在:關鍵變數在於 AI 在流程裡被放在什麼位置——是取代人類做最終判斷,或是在人類做判斷之前。
JPMorgan:詐欺偵測系統實際上怎麼運作
對照 JPMorgan 的案例可以看到同樣的邏輯,落實在具體的技術細節上。獨立研究者 John Brewton 與 Hodman 在 2026 年 1 月發表的技術架構分析描述,JPMorgan 的詐欺偵測系統每天要處理近 10 兆美元、約 80 億筆交易,平均每秒約 9.3 萬筆,尖峰時段超過 20 萬筆,每一筆都必須在毫秒等級的時間內完成分析,才能在付款完成前攔截可疑交易。
系統運作時會同時檢視數十項訊號——交易金額、商家類型、地點、時段、帳戶年齡、消費習慣、近期交易頻率,以及是否與已知的詐欺帳戶有連結,並透過 Kafka 與 Flink 這類能即時處理大量資料流的工具,用預先計算好的統計摘要即時更新風險分數,做法有別於每次都重新計算整批歷史資料。這套系統相較傳統規則式偵測方法,準確率提高 40%,代表能在攔截真實詐欺的同時,減少誤擋正常交易的比例——分析指出,這類系統帶來的價值容易被低估,因為它防止的是原本會發生的損失,價值定位與創造看得見的新營收有別。
模型更新的方式,是分析裡描述得最具體的部分:新模型上線前,會先進入「分身部署」階段——也就是讓新模型跟現有模型並行運作,比對兩者的判斷結果差異,但實際決策仍交給舊模型,新模型只在旁邊「觀察學習」;確認沒問題後,才進入「金絲雀部署」階段——也就是先讓新模型接手一小部分真實交易,一般是 1% 到 5%,像礦坑裡的金絲雀一樣,如果出狀況能提早示警,確認表現穩定後才逐步擴大到全部流量;整個過程都有自動化監控機制,一旦指標出現惡化,系統可以自動撤回部署。
詐欺手法每年約以 12% 的速度演變,這套持續重新訓練、逐步驗證的機制,讓系統能跟上手法的變化,定位為持續演進的做法,有別於用一套固定不變的模型長期運作。(以上 JPMorgan 技術架構描述引自 John Brewton 與 Hodman 的第三方獨立研究,非 JPMorgan 官方揭露)
DBS:七年打底之後,治理框架怎麼跟著長出來
新加坡 DBS(星展銀行)的案例則示範了「投入的時間長度」跟「治理責任」這兩個環節如何互相銜接。ComputerWeekly 在 2024 年 2 月的報導引述該行資料暨轉型長 Nimish Panchmatia 的說法:DBS 成立了一個橫跨 700 位資料專業人員的「Data Chapter」,任務是把資料分析、AI、機器學習的價值規模化,同時深化跨部門的專業知識交流;該行也建立了分級的培訓課程,讓不需要每天接觸資料分析的員工,到想精進技能的資料專家,各自都有對應的學習路徑,2021 年以來已有超過 9,000 名員工完成相關培訓課程。這七年的資料基礎,讓 DBS 在生成式 AI 浪潮來臨時,不必從零開始建立資料治理的組織架構。
具體成效反映在數字上:報導指出,DBS 過去兩年將 AI 帶來的經濟效益從 1.5 億新加坡元提升到超過 3.7 億新加坡元;另據《海峽時報》(The Straits Times)2025 年 6 月的報導,DBS 生成式 AI 與工作流程負責人 Rajeev Hassamal 在 SuperAI Singapore 大會上表示,該行累積超過 350 個 AI 用例、1,500 個上線模型,2024 年透過 AI 創造的經濟價值達 7.5 億新加坡元,預估 2025 年可望突破 10 億新加坡元。DBS 內部生成式 AI 工具 DBS-GPT 在新加坡總部已有超過 5,000 名員工使用,協助處理內容生成與文書撰寫工作。
治理機制上,ComputerWeekly 報導提到,DBS 建立了一套內部框架,在 AI 用例正式核准前先確認每個用例背後有明確目的、且結果必須具備可解釋性;該行同時成立由資深主管組成的專責小組,定期檢視 AI 治理與控管機制中的落差,尤其是生成式 AI 相關的專案。這跟前面談到的「員工願不願意用」也有交集——Rajeev Hassamal 在同一場 SuperAI Singapore 大會上直接點出挑戰所在:「要在創新與 AI 的負責任使用之間找到平衡點非常困難」,這句話出自實際負責推動 AI 導入工作的主管之口,反映的是七年基礎打完之後,接下來要處理的問題已經從「有沒有資料」轉移到「怎麼負責任地擴大規模」。
新加坡金融管理局(MAS)在這個案例裡也扮演了重要角色,但層次不同於 DBS 自己的內部治理。《海峽時報》報導提到,MAS 於 2023 年啟動 Project MindForge 研究生成式 AI 在銀行業的風險與機會,並計畫於 2025 年發布產業通用的風險考量手冊。這代表 DBS 面對的治理壓力,同時來自內部(自建的用例審核框架、專責小組)與外部(監理機關的產業指引),兩層治理各自運作,沒有互相取代。
把這幾個案例並列後可以看出,機會與挑戰的分水嶺,落在企業如何對待模型的持續判斷能力——是否建立了測試、監控、逐步驗證的機制,還是把模型的初次判斷結果直接當作可以規模化的定論。
五個提問檢視資料、員工、架構與責任是否到位
從各公司轉型的關鍵時間點來看,不論是數位轉型或是 AI 轉型,幾乎都不是一蹴可及的過程,企業通常得在橫向跟縱向同時展開。前面拆出的每個環節,可以直接轉換成企業自我檢視的提問:資料整合進結構化系統的工作,進行到什麼階段?員工對 AI 工具的使用,是被要求才用,還是已經變成日常工作習慣的一部分?基礎架構能不能承載現在想上線的 AI 場景規模?供應商佈局是否已經決定了自建控制層還是依賴外部平台,或是這個決定還沒做?治理責任是否已經拆分給不同角色,各自對應不同性質的風險?以及最容易被忽略的一項——模型上線後,是否建立了持續驗證與逐步監控的機制,或是把第一版的判斷結果當作已經可以規模化的答案?
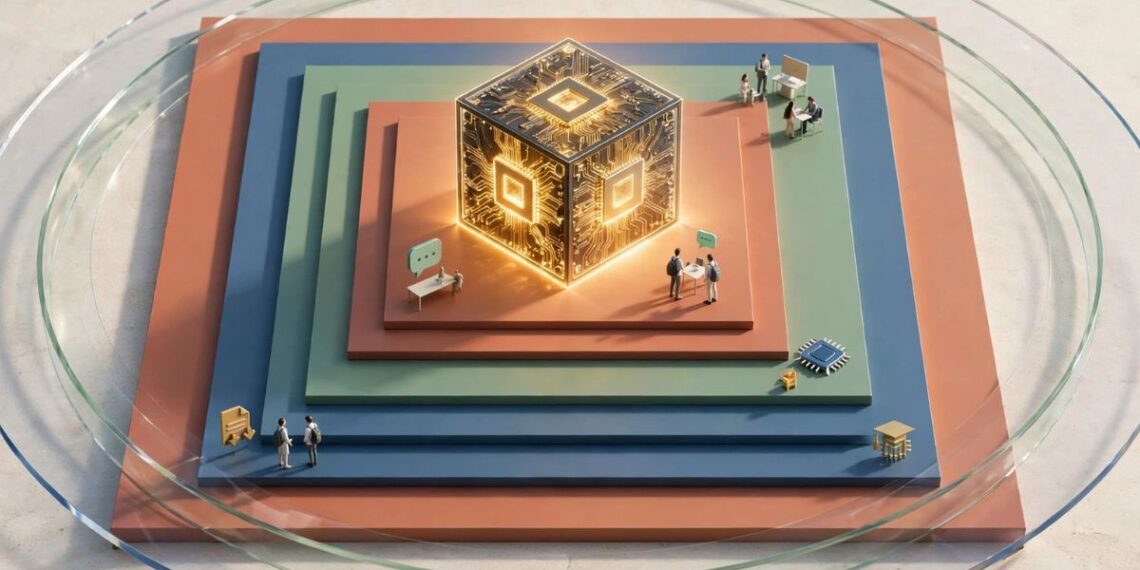
案例企業用不同方式回答了前面幾個提問。Zillow 案例則從 2021 到 2026 年的完整軌跡,點出另一個常被低估的重點——前面幾項到位,AI 在流程裡被放在什麼位置,仍需要持續檢驗與調整,這項工作沒有一次性完成的終點。而 Zillow 與 JPMorgan 的案例顯示,模型上線後的驗證、監控、調整工作從來沒有停止過——這比較像一個持續循環的過程,定位為循環演進,有別於走完一段路、蓋好一層基礎就能踏上下一級階梯的線性程序。
※資料來源說明:本文引用之機構研究與企業案例分別來自 Moderna 官方新聞稿與 2023 年 11 月 8 日投資人事件逐字稿、McKinsey 官方案例研究、JPMorgan 官方技術部落格、CIO Dive、Walmart 官方技術部落格、ComputerWeekly、哈佛商學院工作論文與 GeekWire、SiliconANGLE 對 Zillow 2021 年案例的交叉報導,以及 GeekWire 於 2026 年 2 月、5 月的後續報導與 Zillow 官方新聞稿對該公司 2026 年 AI 布局的說明。John Brewton 與 Hodman 對 JPMorgan 技術架構的分析為第三方獨立研究,非 JPMorgan 官方發布,文中標註處建議與官方財報或投資人簡報交叉確認後再引用。
(本文授權非營利轉載,請註明出處:CIO Taiwan)